ComfyUIとOllamaの組み合わせの可能性(2)
公開日:
- 開発
引き続きローカルLLM
気軽に画像を生成するなら,ChatGPTなり,Geminiなり叩いた方が速いです。
例えば,
20歳ぐらいの男性。スーツを着て屋上からジャンプする。視点は上空。イラストを描画せよ。
と投げると次のイラストが描画される。
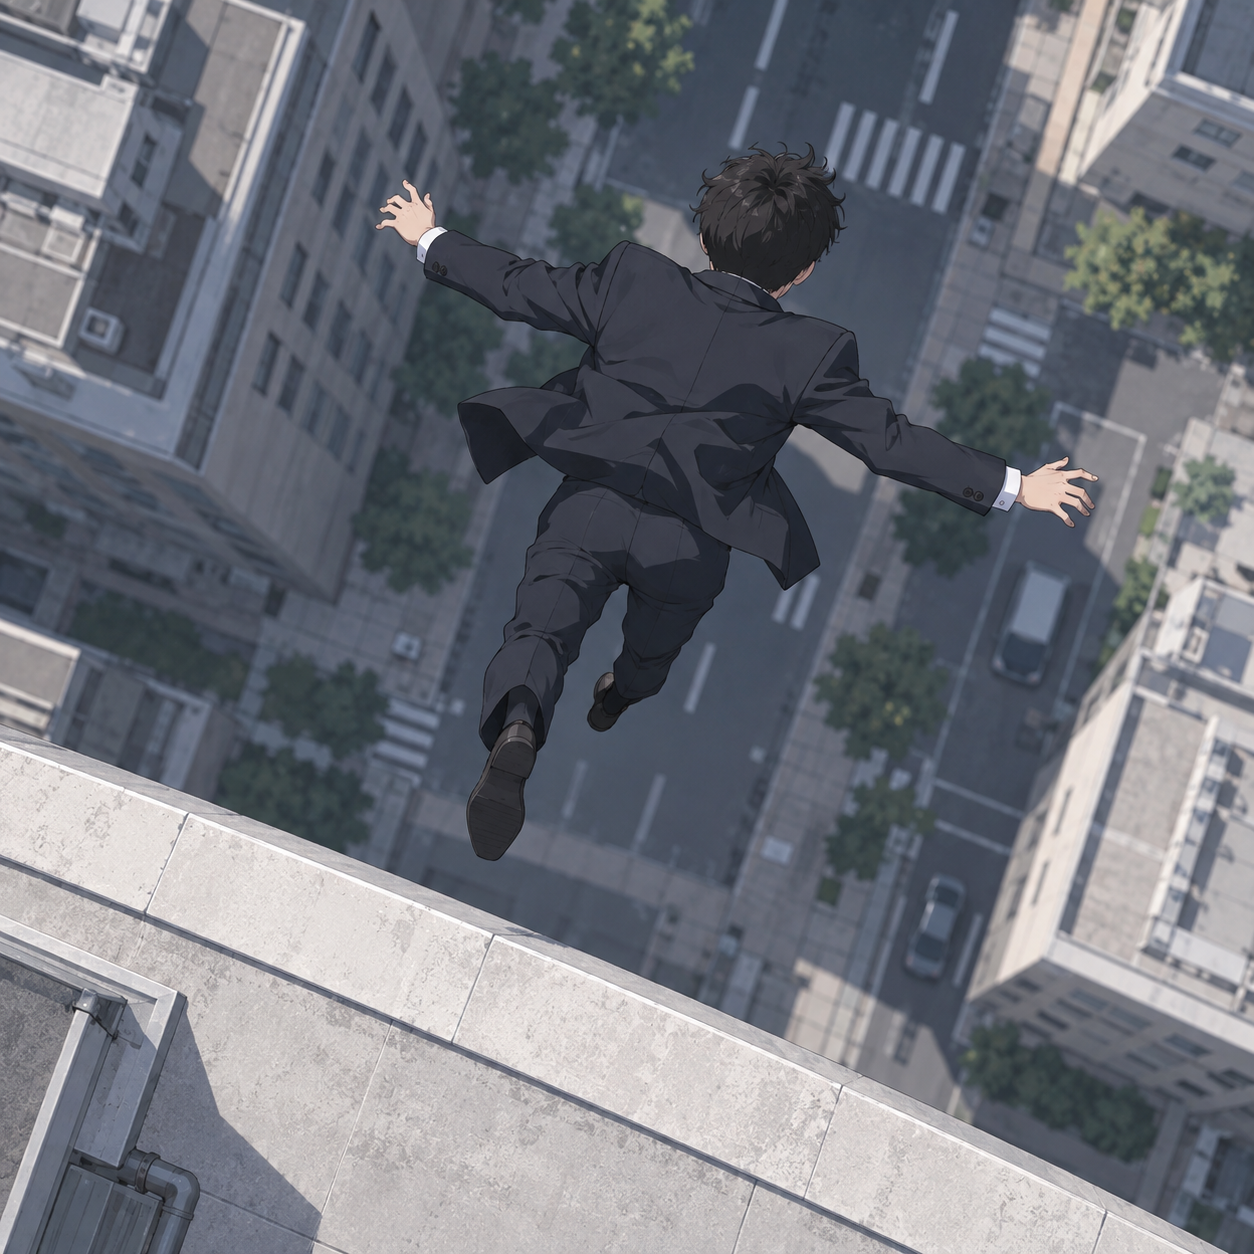
もう一度投げると別のイラストが描画されるでしょう。
ローカルLLMで画像生成するのも面白い。
上のようにChatGPTらは高速に画像生成できますが,
おそらく推論で画像生成した結果に,
何度も「判定」と再描画が入っているのではないでしょうか。
もっと,こうした方が良いのではないか。
この表現は不適切だから直した方が良いのではないか。
この結果は出力しない方が良いのではないか。
結果,ユーザーが望む安定した画像が出力される。
これは私が適当に推測しているので,実際は異なる可能性は高いです。
さて,ローカルLLMの場合,
使用するモデルや設定によっては,
足が3本あるイラストや,
髪の色が変,
顔と服のバランスが変,
といった修正すべき画像がいとも簡単に生まれます。
さらに,生成された画像をローカルLLMに評価させても,
こうした問題を十分に検出できないことがあります。
初期に,ラーメンを手ですくって食べる生成AI画像がありましたが,
その雰囲気と同じことが体験できます。
今回,画像生成に使用したプロンプトと,
生成画像に対するローカルLLMの評価結果は,次のとおりです。
なお,このプロンプトは,
20歳ぐらいの男性。スーツを着て屋上からジャンプする。視点は上空。イラストを描画せよ。
をシチュエーションとして投げて,Ollamaに出力させたものです。
実行プロンプト:
1 man, 20 years old, male, wearing suit, jumping from rooftop, aerial view, bird's eye view, masterpiece, high score, great score, absurdres

実行ネガティブプロンプト:
ground level view, indoor, casual clothes, t-shirt, jeans, worst quality, low quality, low score, bad score, average score

一致: 画像には20歳前後の男性が描かれている。
画像中央に若い男性のキャラクターが描かれている。

一致: 男性はスーツを着用している。
男性は黒いスーツを着用している。

一致: 男性は屋上からジャンプする動作をしている。
男性は空中に浮いており、ジャンプしているように見える。背景には都市の建物が見える。

一致: 視点は上空から俯瞰している。
カメラアングルは上から下を向いており、俯瞰の視点である。

不確実性: 画像の全体的な構図、キャラクターのポーズ、服装、視点はいずれも基準を満たしている。ただし、プロンプト内の 'masterpiece, high score, great score, absurdres' などの品質タグは、Animagine XL 4.0 のような特定のモデルでは不要な場合があり、生成の安定性を妨げる可能性がある。
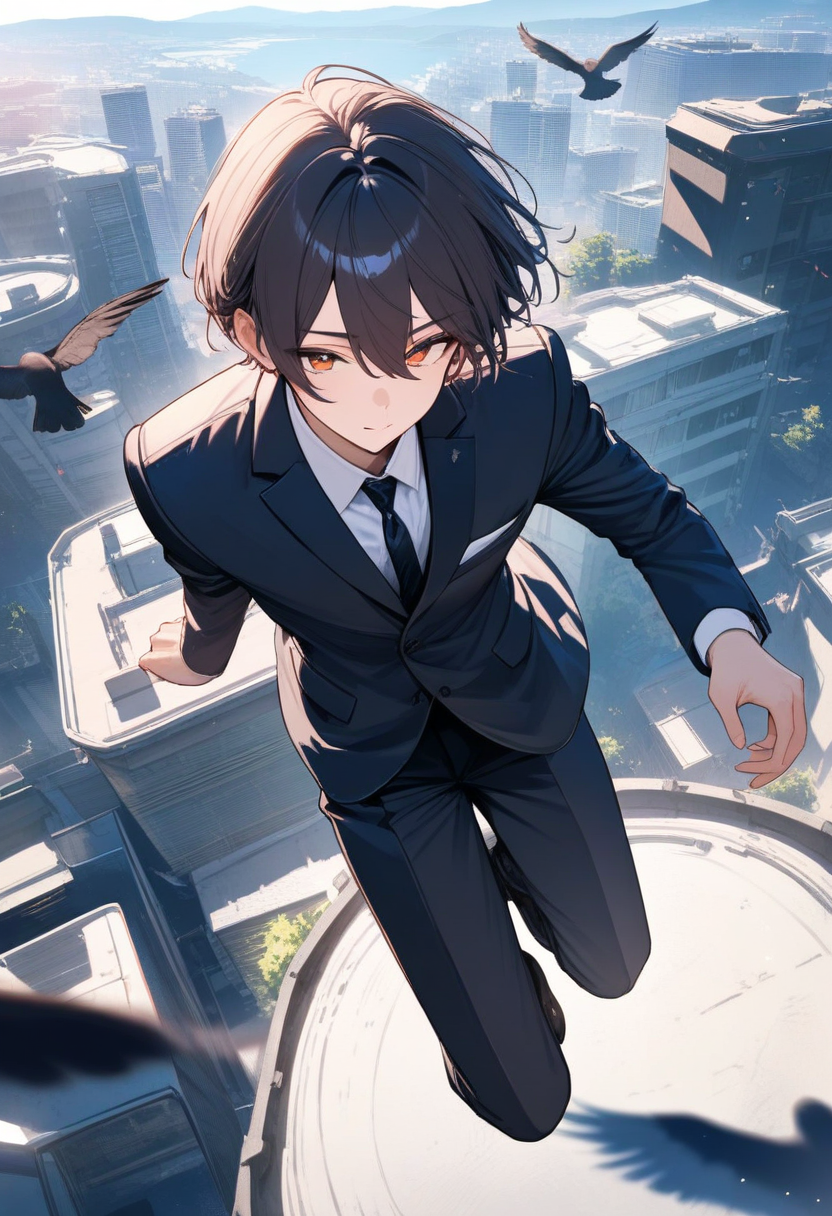
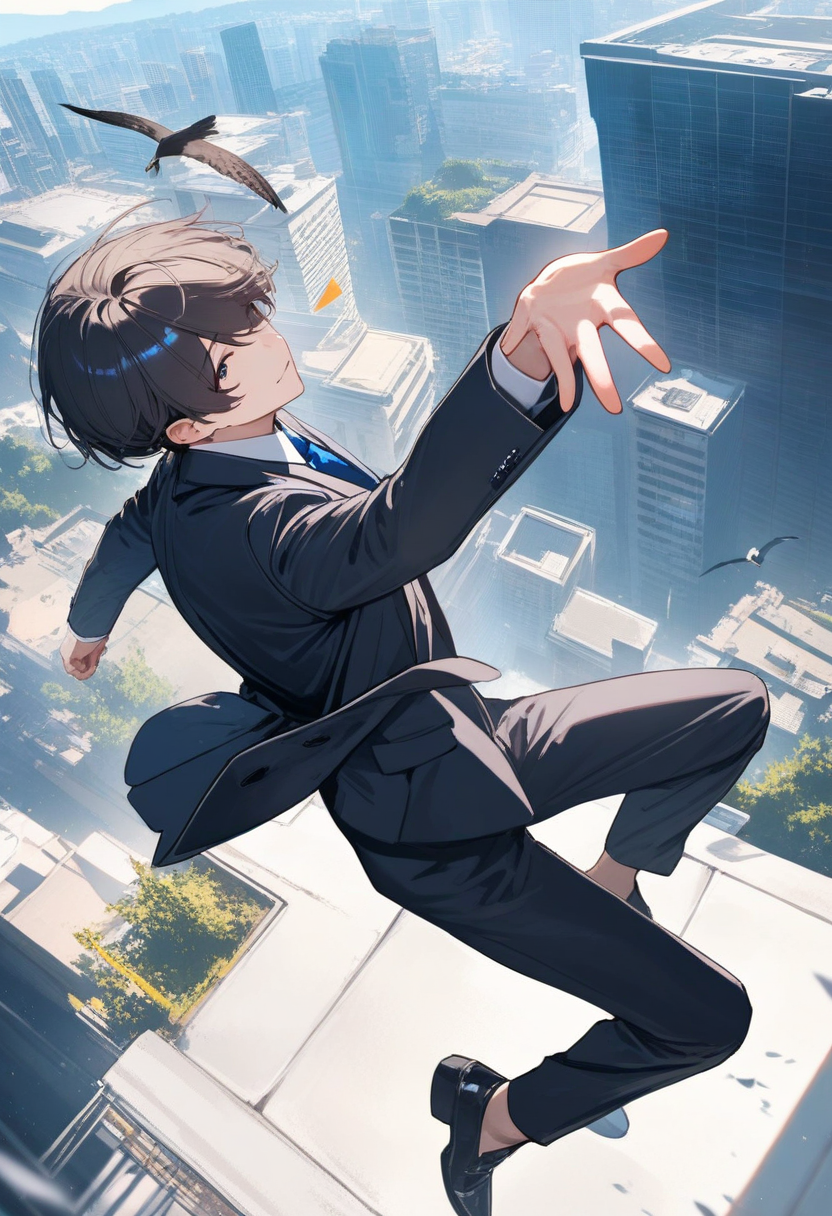
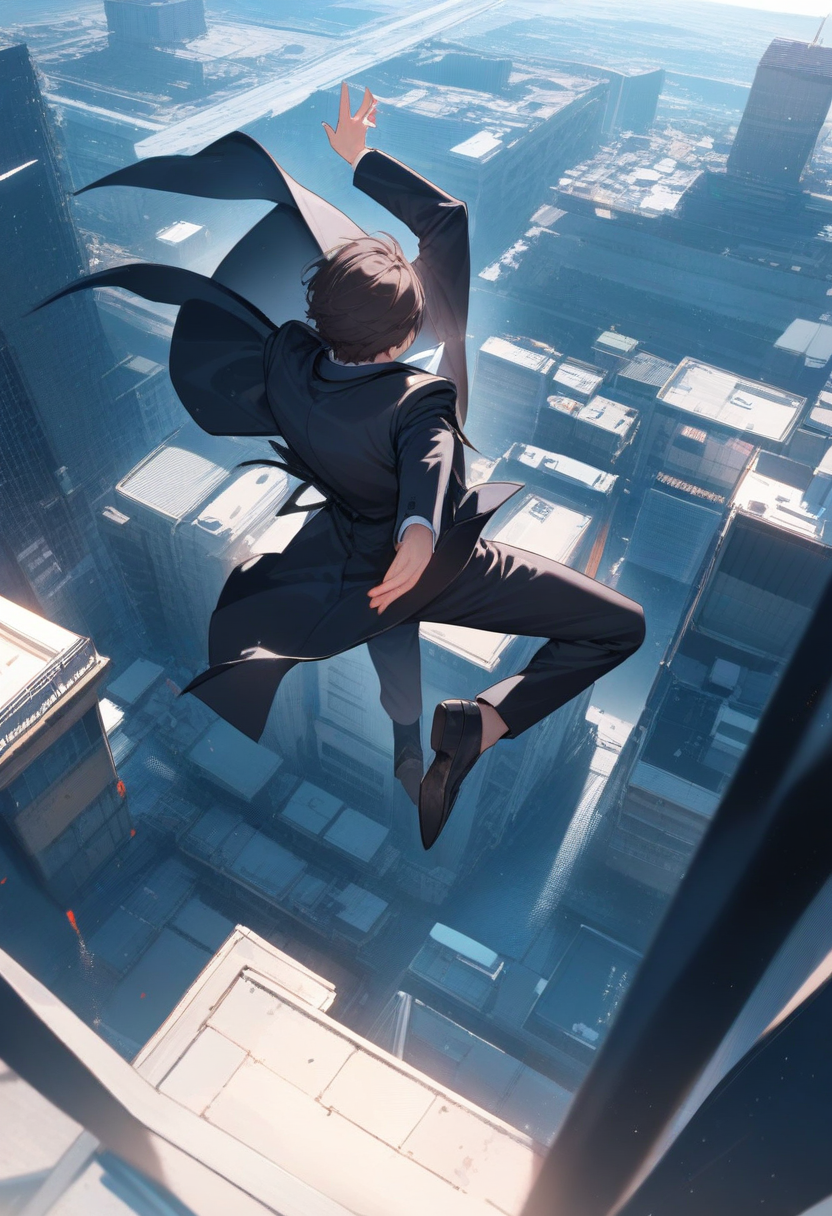
よく見ると,細部がおかしい,
あるいはよく見なくともおかしい箇所があると思います。
なお,評価結果も検討すべき箇所があります。
例えば,Animagine XL 4.0の公式資料では,
ここで不要と指摘されている品質タグが推奨されています。
ローカルでの画像出力の結果は,画像生成時のステップ数やCFG値,
Seed値などを調整することで変わってくると思います。
しかし,さまざまな条件を効率よく,短時間で検証するためには,
より高性能なGPUが必要になりそうですね。
RTX 5060でもComfyUIは動かせますが,そこまで「速く」は出力できない。
ただ,そのRTX 5060の方が,私の環境ではMac Studio(M4 Max)よりも速いです。
クラウドでGPUを借りるのも手ですが,従量課金がかかりますし。
効率だけを考えれば,ChatGPTやGeminiで画像を生成した方が速いし,楽です。
実際,私もそうしています。
ただ,パラメータを調整すると,生成結果が変わる。
このパラメータを自分で操作し,結果の違いを確かめられることが,
ローカル環境で画像生成する面白さなのでしょう。